Google añade TPU 8i Max y TPU 8tx a su octava generación de chips de IA: contexto gigante y computación confidencial
Google amplía su octava generación de TPU con dos nuevos sistemas: TPU 8i Max, que reúne dos chips 8i en un mismo encapsulado para contextos muy extensos, y TPU 8tx, que protege los datos y los pesos de los modelos durante el cómputo. Sin precios, regiones ni fecha de disponibilidad.

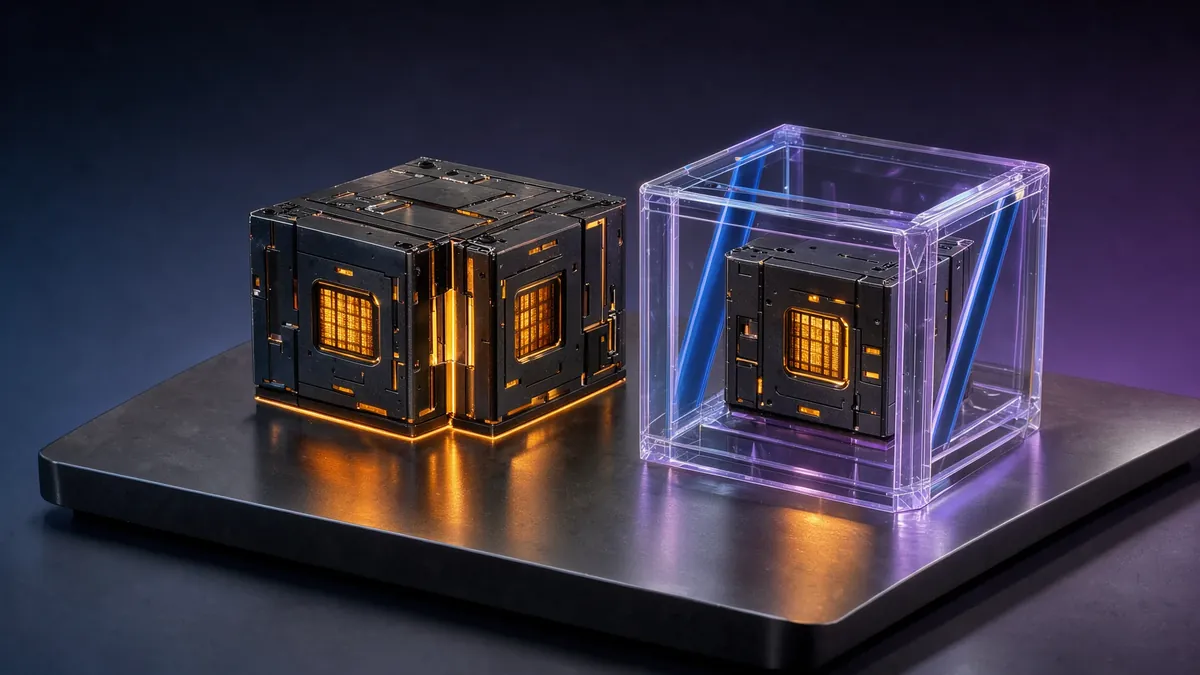
Google no ha diseñado un nuevo chip, pero ha creado dos nuevas máquinas a partir de los existentes. Este lunes 9 de noviembre, la empresa sumó TPU 8i Max y TPU 8tx a la octava generación de sus aceleradores de IA, a través de un artículo de Amin Vahdat, su responsable técnico de infraestructura de IA. El primero está orientado a contextos muy amplios; el segundo, a los datos sensibles. Junto con TPU 8t y TPU 8i, presentados en abril, ya son cuatro sistemas TPU en un año, algo inédito según Google.
Dos configuraciones, no dos nuevos chips
Google recalca la diferencia: diseñar un chip requiere años, mientras que un sistema (la manera de ensamblar chips, memoria, red y seguridad) puede desarrollarse en cuestión de meses. Ambas novedades reutilizan, por tanto, el silicio existente.
TPU 8i Max busca superar el «muro de la memoria». Cuando decenas de agentes operan de forma conjunta sobre bases de código completas o sobre horas de vídeo, es el ancho de banda de la memoria lo que genera el cuello de botella, más que la propia capacidad de cómputo. Por ello, Google reúne dos chips TPU 8i en un único encapsulado: el doble de cómputo, de memoria SRAM y de ancho de banda HBM respecto a TPU 8i, ocupando el mismo espacio de bastidor y ofreciendo, en consecuencia, mayor potencia por metro cuadrado y por vatio. Según Network World, tras consultar a Mark Lohmeyer, de Google Cloud, esto equivale a 384 GB de HBM, 17,2 TB/s de ancho de banda y 768 MB de SRAM; estos datos no aparecen en la publicación oficial.
TPU 8tx aprovecha el chip de TPU 8t, concebido para entrenamiento, combinado con procesadores host AMD EPYC de 5.ª generación. Su rasgo distintivo es la computación confidencial. Por regla general, los datos se cifran en reposo y durante su transferencia, pero se descifran en memoria al procesarse. TPU 8tx los mantiene protegidos y aislados incluso durante el cómputo, incluidos los pesos del modelo. Google lo enfoca a entidades reguladas y administraciones públicas interesadas en ejecutar modelos y agentes sobre su información más confidencial, permitiendo además realizar ajustes finos, destilación o aprendizaje por refuerzo sin desplazar esos datos. Valiéndose de la red de baja latencia de TPU 8i, Google asegura lograr una latencia hasta dos veces menor que la de TPU 8t.
El software, la otra mitad del anuncio
Google acompaña este hardware con una serie de herramientas pensadas para facilitar el uso de sus TPU tanto como el de las GPU. Ha publicado en código abierto TPU Sync, una capa que distribuye el estado de los modelos (en particular la caché KV para contextos largos) entre la memoria de los chips, la de los servidores y el almacenamiento, reduciendo en más del 90%, según afirman, el tiempo transcurrido hasta emitir el primer token. También presenta en fase preliminar una suite de agentes TPU de código abierto que se integra con Claude Code, Cursor o Google Antigravity para migrar y optimizar código. A esto se añaden el motor de inferencia de código abierto XLA Serving Engine, el software Agent Compute Engine, que suspende sesiones de agentes inactivas para liberar los aceleradores, y la disponibilidad general de Cloud Pathways y de la partición dinámica de clústeres de TPU en GKE, su servicio gestionado de Kubernetes.
Lo que falta
Google no ha proporcionado precios, regiones ni fechas de disponibilidad para ninguno de los dos sistemas. Las mejoras de rendimiento citadas corresponden a pruebas internas de la compañía, sin auditorías independientes publicadas. La empresa afirma contar con cerca de 100 clientes para sus TPU, incluidos laboratorios de IA de primer nivel, y prevé ofrecer más detalles en una retransmisión este lunes a las 18:00, hora de París.
Nuestro análisis
El mensaje de Google es tanto industrial como tecnológico: demostrar su capacidad para adaptar sus chips al ritmo de las necesidades del mercado, terreno en el que Nvidia continúa dominando. TPU 8i Max atiende de forma directa a la proliferación de contextos de un millón de tokens y de agentes que operan durante horas, cuyo coste depende fundamentalmente de la memoria. Por su parte, TPU 8tx abre un segmento que las GPU ya cubren mediante computación confidencial: banca, sanidad y sector público. No obstante, al carecer de precios y calendario, resulta inviable calibrar su atractivo frente a la competencia. La apuesta más determinante sigue siendo el software: al facilitar la ejecución nativa de PyTorch y de motores de inferencia abiertos en TPU, Google mitiga el principal motivo para no salir del ecosistema de Nvidia.
Fuentes
- Google — Our newest TPUs: 8tx and 8i Max, built for the agentic era (9 de noviembre de 2026) Fuente primaria
- Google Cloud en X — Meet TPU 8i Max and TPU 8tx Fuente primaria
- Network World — Google targets AI's next infrastructure bottlenecks with two new TPUs (9 de noviembre de 2026) Fuente secundaria
Una fuente primaria procede directamente de la empresa, el laboratorio o la organización implicados. Una fuente secundaria recoge la información sin ser su autora: la señalamos como tal. ¿Has visto un error? Consulta nuestra política de correcciones.


